وقتی صحبت از توسعه مدلهای زبانی بومی میشود، یک باور عمومی اشتباه وجود دارد: «مدلهای بومی توان رقابت با خروجی آزمایشگاههای بزرگ هوش مصنوعی دنیا را ندارند.»
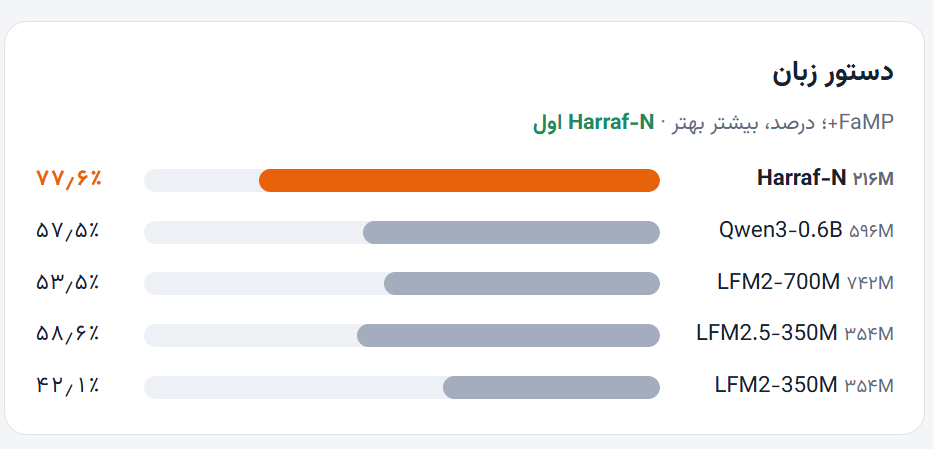
امروز با افتخار نتایج بنچمارک رسمی مدل حراف (نسخه ۱۶ مدل زبانی حراف) را منتشر میکنم. مدلی با ۲۱۶ میلیون پارامتر که برای پردازش هر کلمه تنها از ۱۱۵ میلیون پارامتر فعال استفاده میکند، اما در آزمونهای استاندارد زبان فارسی توانسته مدلهایی مانند Qwen3-0.6B (با ۵۹۶ میلیون پارامتر) و سری LFM2 (تا ۷۴۲ میلیون پارامتر) را در اکثر سنجهها پشت سر بگذارد.
در این مقاله، تمامی سنجهها، ارقام دقیق، روند رشد حل مسائل ریاضی از نسخه ۵ تا ۱۶ و البته نقاط ضعف و چالشهای حلنشده را به صورت کاملاً شفاف و مستند با شما به اشتراک میگذارم.
شناسنامه مدل ایرانی حراف در یک نگاه
- نام مدل: حراف
- توسعهدهنده: علی جهانی
- تعداد کل پارامترها: ۲۱۶ میلیون پارامتر
- پارامترهای فعال در هر توکن: ۱۱۵ میلیون پارامتر (با معماری جداسازی حافظه دانش)
- نوع مدل: مدل پایهی از صفر آموزشدیده (کاملاً Native و بدون فاینتیون روی مدلهای خارجی)
- نتیجه در بنچمارک: برنده در ۷ سنجه از کل ۹ سنجه ارزیابی
جدول مقایسه جامع: حراف در برابر مدلهای باز جهانی
تمام مدلهای حاضر در این آزمون در شرایطی کاملاً یکسان، تحت یک متدولوژی واحد و به صورت Zero-Shot (بدون نمونه راهنما) روی زبان فارسی ارزیابی شدهاند:
سنجه و آزمون معیار برتری حراف (۲۱۶M) Qwen3-0.6B (۵۹۶M) LFM2-700M (۷۴۲M) LFM2.5-350M (۳۵۴M) LFM2-350M (۳۵۴M) دستور زبان (FaMP+) بیشتر بهتر ↑ ۷۷.۶٪ 🥇 ۵۷.۵٪ ۵۳.۵٪ ۵۸.۶٪ ۴۲.۱٪ فشردهسازی متن (bpc) کمتر بهتر ↓ ۱.۲۵۵ 🥇 ۲.۳۲۴ ۲.۲۷۴ ۲.۸۴۰ ۲.۴۶۰ درک مطلب (PQuAD – دقت) بیشتر بهتر ↑ ۵۵.۴٪ 🥇 ۲۳.۷٪ ۱۹.۰٪ ۵.۰٪ ۹.۵٪ درک مطلب (PQuAD – نمره F1) بیشتر بهتر ↑ ۳۶.۹٪ 🥇 ۲۰.۹٪ ۲۵.۲٪ ۹.۹٪ ۱۵.۰٪ استخراج اعداد در درک مطلب بیشتر بهتر ↑ ۶۲.۲٪ 🥇 ۳۲.۹٪ ۲۵.۶٪ ۹.۸٪ ۱۱.۰٪ تشخیص عدم وجود پاسخ بیشتر بهتر ↑ ۷۵.۲٪ ۷۷.۷٪ 🥈 ۷.۴٪ ۰.۸٪ ۱.۷٪ دانستههای عمومی (۲۴ پرسش) بیشتر بهتر ↑ ۴۱.۷٪ 🥇 ۰٪ ۰٪ ۰٪ ۰٪ ریاضیات کلامی (بدون ماشینحساب) بیشتر بهتر ↑ ۷۰.۰٪ 🥇 ۴۰.۰٪ ۰٪ ۰٪ ۰٪ مسائل چندمرحلهای (ParsBench) بیشتر بهتر ↑ ۵.۵٪ ۸.۳٪ 🥈 – – –
تحلیل بخش به بخش بنچمارک: این اعداد چه معنایی دارند؟
۱. دستور زبان و ادراک واژگان (FaMP+)
در تست FaMP+ که قدرت مدل در تفکیک ساختار درست زبان فارسی از جملات اشتباه را میسنجد، حراف نمره ۷۷.۶٪ را ثبت کرد. در مقایسه، نزدیکترین رقیب یعنی Qwen3 با بیش از ۲.۷ برابر اندازه بزرگتر، نمره ۵۷.۵٪ را به دست آورد. دلیل این اختلاف چشمگیر، توکنساز بومی حراف است که ریشه کلمات، پیشوندها و پسوندهای فارسی را اصولی خرد میکند.
۲. فشردهسازی متن فارسی (bpc روی دیتای دیدهنشده)
شاخص bpc (بیت به ازای هر حرف) نشان میدهد مدل چقدر زبان فارسی را بهینه میفهمد؛ هرچه عدد کمتر باشد، تسلط مدل بر زبان بیشتر است.
حراف به عدد فوقالعاده ۱.۲۵۵ رسید، در حالی که مدلهای دیگر همگی بالای ۲.۲ هستند. این یعنی حراف با صرف کمترین انرژی پردازشی، معنای واژگان فارسی را پیشبینی میکند.۳. درک مطلب و فهم متون (PQuAD)
روی ۵۰۰ سوال آزمون دیتاست دانشگاهی PQuAD:
- حراف در ۵۵.۴٪ مواقع پاسخ صحیح را در خروجی آورده است (بیش از دو برابر رقیب ۵۹۶ میلیونی).
- در سوالاتی که پاسخ آنها یک عدد بوده (تاریخ، سن، مقدار)، حراف به دقت ۶۲.۲٪ دست یافته است.
۴. صداقت و توهمزدایی («در متن نیامده»)
یکی از چالشهای بزرگ هوش مصنوعی، پاسخسازی برای چیزهایی است که اصلاً در متن منبع وجود ندارد.
در نگاه اول، نمره Qwen3 با ۷۷.۷٪ بالاتر از حراف (۷۵.۲٪) به نظر میرسد، اما یک نکته آماری بسیار مهم در لاگها پنهان بود:Qwen3 در ۵۴٪ مواقع برای سوالاتی هم که جوابشان در متن بود، به اشتباه میگفت «در متن نیامده»! در حالی که نرخ این خطای حراف فقط ۴.۵٪ بود. حراف یاد گرفته که پاسخ بیهوده نسازد اما پاسخهای موجود را هم نسوزاند.
شگفتی ریاضیات: از ۰٪ تا ۷۰٪ بدون ماشینحساب!
شاید هیجانانگیزترین بخش توسعه حراف، یادگیری محاسبات ریاضی بود. مدلهای زبانی معمولاً ارقام را مثل حروف انگلیسی یا فارسی میبینند و جمع و تفریق چندرقمی را حدس میزنند (که معمولاً اشتباه از آب درمیآید).
ما حراف را طوری آموزش دادیم که مانند یک دانشآموز دبستانی، مسئله را کلمه به کلمه بخواند، عملگر ریاضی را تشخیص دهد و عملیات را رقمبهرقم با قرضگرفتن روی کاغذ پیاده کند.
روند پیشرفت حل ۲۰ مسئله کلامی دستنویس در نسخههای مختلف حراف را ببینید:
codeText
نسخه ۵ : [ 0% ] (ناتوان در محاسبات) نسخه ۶ : [ 5% ] (اولین جرقههای استدلال) نسخه ۷ : [ 15% ] نسخه ۸ : [ 35% ] نسخه ۹ : [ 40% ] نسخه ۱۰ : [ 65% ] نسخه ۱۳ : [ 50% ] (تغییر پایپلاین و افت موقت) نسخه ۱۴ : [ 60% ] نسخه ۱۵ : [ 55% ] نسخه ۱۶ (حراف 16): [ 70% ] 🚀 نسخه های بعدی ( در حال اجرا )حراف در نسخه ۱۶ توانست ۷۰٪ مسائل کلامی را با استدلال زنجیرهای بنویسد، در حالی که Qwen3-0.6B روی همین آزمون به ۴۰٪ رسید و مدلهای LFM2 موفق به حل هیچکدام نشدند (۰٪).
صداقت علمی: مدل حراف کجا هنوز ضعف دارد؟
هیچ بنچمارکی بدون بیان نقاط ضعف معتبر نیست. ما تعمداً آزمونهایی را طراحی کردیم که مرزهای توانایی حراف را مشخص کند:
- مسائل چندمرحلهای سنگین (ParsBench):
در آزمون ۱۴۵ مسئلهای پیچیده پارسبنچ، حراف به نمره ۵.۵٪ رسید در حالی که Qwen3 نمره ۸.۳٪ را ثبت کرد. این نشان میدهد در زنجیرههای طولانی استدلال که به حافظه کاری بزرگی نیاز دارند، پارامترهای بیشترِ رقیب خود را نشان میدهند. این چالش اصلی نسخه بعدی حراف خواهد بود.- پیشزمینه و بایاس دادهای:
بخش آزمون ویکیپدیای فارسی متنی همجنس با دادههای پیشآموزش حراف بوده است؛ بنابراین برای سنجش بیطرفانهتر، همچنان در حال افزودن دیتای متون نوین به سیستم تست هستیم.
چرا این بنچمارک اهمیت دارد؟
- اثبات کارآمدی معماری: مدل زبانی ایرانی حراف ثابت کرد که با توکنساز درست و معماری هوشمندانه تفکیک حافظه، یک مدل ۲۱۶ میلیونی میتواند مدلهای ۳۵۰ تا ۷۴۰ میلیونی خارجی را در درک زبان مادریشان شکست دهد.
- قابل اجرا روی سیستمهای ضعیف: اجرای مدلی با ۱۱۵ میلیون پارامتر فعال، نیازی به کارتهای گرافیک سازمانی گرانقیمت ندارد و روی پردازندههای معمولی (CPU) لپتاپ به راحتی پاسخ میدهد.
- گام بعدی: نتایج به دست آمده در نسخه ۱۶ مسیر را برای توسعه مدلهای چندمیلیاردی بومی هموار کرده است.
همراه ما باشید!
کدها، روند توسعه، دیتاسورسها و اخبار نسخههای بعدی حراف به صورت آزاد و شفاف در کانال تلگرام به اشتراک گذاشته میشود. اگر به هوش مصنوعی و پیشرفت فناوری در ایران علاقهمندید، به جمع ما بپیوندید:
🔗 عضویت در کانال تلگرام ترفندون (tarfandoonchannel@)